OpenAI führt GPT-6.1 Ultrafast-Modus ein – bis zu 8-mal schnellere Generierung
de.wedoany.com-Bericht: Am 8. Oktober hat das US-amerikanische KI-Unternehmen OpenAI offiziell den Ultrafast-Modus (Ultraschnell-Modus) von GPT-6.1 Sol eingeführt, der OpenAI API, Codex und ChatGPT Work abdeckt. Die Token-Generierungsgeschwindigkeit dieses Modus erreicht bis zu das 8-Fache des Standardmodus. Die API-Preise betragen 12 US-Dollar pro Million Eingabe-Token und 60 US-Dollar pro Million Ausgabe-Token, was dem 6-Fachen des Preises des Standardmodus entspricht. Der neue Modus richtet sich hauptsächlich an Aufgaben wie Software-Debugging, Agenten-Betrieb von Anwendungen und Interaktionen mit geringer Latenz.
Auf der API-Seite können Entwickler das Modell gpt-6.1-sol über die Responses API aufrufen und den Ultrafast-Modus aktivieren, indem sie service_tier auf ultrafast setzen. Dieser Modus unterstützt WebSocket-Verbindungen und bietet auch HTTP-Aufrufmethoden. Die OpenAI-Entwicklerdokumentation zeigt, dass der Ultrafast-Modus für alle API-Nutzer verfügbar ist, tatsächliche Aufrufe jedoch weiterhin Rate-Limits unterliegen.
In Codex und ChatGPT Work ist der Ultrafast-Modus derzeit für Abonnenten von Pro 500, berechtigte Enterprise-Nutzer mit nutzungsbasierter Abrechnung sowie Education-Nutzer mit Credit-Abrechnung verfügbar. Enterprise-Administratoren müssen den entsprechenden Zugriff für ihre Organisation aktivieren. Der Rollout umfasst alle unterstützten Regionen und bietet Datenresidenz-Unterstützung für die USA und die EU. OpenAI fügt zudem gleichzeitig EU-Datenresidenz-Unterstützung für GPT-6.1 Sol Fast und GPT-6 Luna Fast hinzu.
GPT-6.1 Sol wurde am 29. September veröffentlicht und ist ein Upgrade-Modell von GPT-6 Sol. Die Standard-API kostet 2 US-Dollar pro Million Eingabe-Token, 10 US-Dollar für die Ausgabe und 0,10 US-Dollar für gecachte Eingabe. OpenAI positioniert es für komplexe Programmierung, Computerbedienung und professionelle Arbeitsaufgaben. Es unterstützt ein Kontextfenster von bis zu 1,05 Millionen Token und eine maximale Ausgabe von 128.000 Token pro Anfrage. Der Ultrafast-Modus verwendet dieselbe Modellkennung und unterscheidet Verarbeitungsgeschwindigkeit und Abrechnungsstandard über die Service-Stufe.
relevante Produkte

Kollaboratives Energiemanagement- und Steuerungssystem für Cloud, Edge und Endgeräte
Beijing Agent Devote Power Technology Development Co., Ltd.
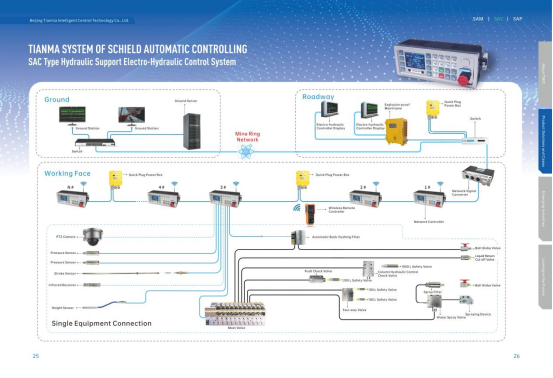
Elektrohydraulisches Steuerungssystem für SAC-Hydraulikausbaugestelle
Beijing Tianma Intelligent Control Technology Co., Ltd.
Baolande Application Server Software V9.5
Beijing Baolande Software Corporation
Tragbares Satellitenterminal mit Flachbildschirm – manuelles tragbares Terminal mit 0,35-Meter-Öffnung
China Starwin Science & Technology co., Ltd.
TWP16 P-Band-Troposphären-Windprofiler-Radar
China Huayun Meteorological Technology Group Co., Ltd.
Intelligentes Überwachungssystem für Förderbänder
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.