NVIDIA veröffentlicht KI-Modell mit 120 Milliarden Parametern und zwei Edge-Computing-Modelle
de.wedoany.com-Bericht: Am 15. Oktober kündigte das US-Unternehmen NVIDIA die Erweiterung der offenen Modellreihe Nemotron 3.5 an und stellte das multimodale Modell Nemotron 3.5 Super VL mit 120 Milliarden Parametern sowie die beiden für lokale Rechengeräte konzipierten Modelle Nemotron 3.5 Bolt 74B-A9B und Bolt E4B vor. Die Versionen Super VL und 74B sind bereits offiziell verfügbar, die 4GB-Version soll am 23. Oktober erscheinen. Die drei Modelle richten sich jeweils an unternehmensweite KI-Agenten, persönliche Rechengeräte und eingebettete Edge-Endgeräte.
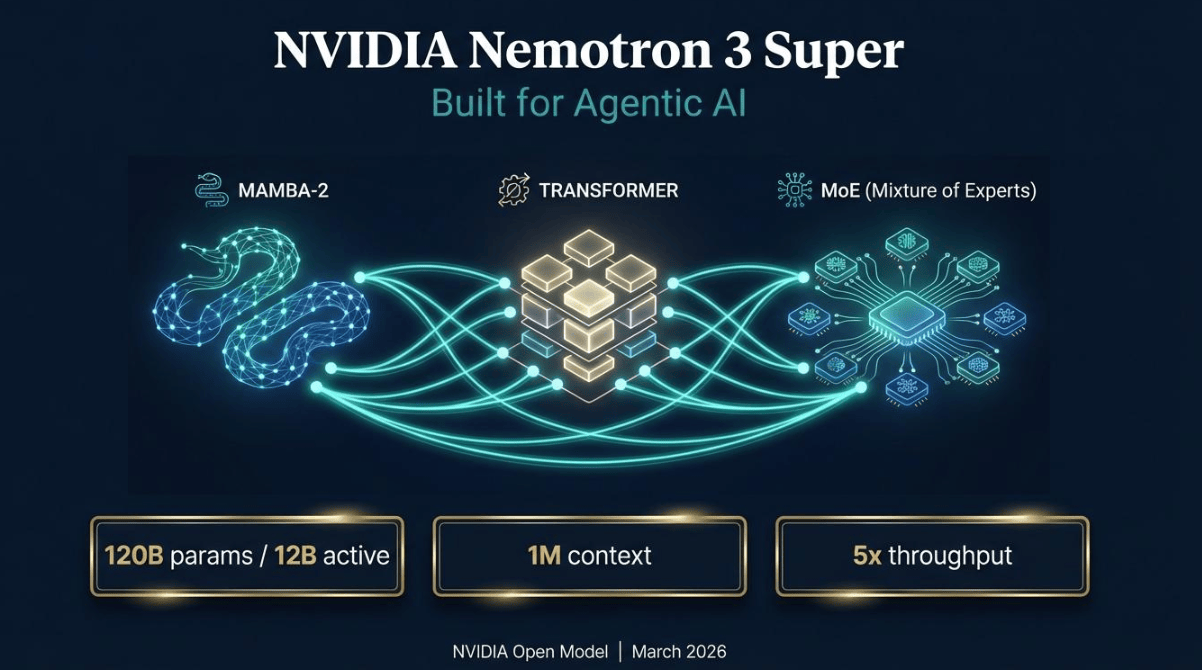
Super VL wurde von NVIDIA gemeinsam mit der Nemotron Coalition entwickelt und unterstützt Instruktionsausführung, Tool-Aufrufe, mehrstufige Geschäftsprozessabwicklung und visuelles Verständnis. Die von NVIDIA veröffentlichten Testergebnisse zeigen, dass die Genauigkeit des Modells bei multimodalen Aufgaben ein vergleichbares Niveau wie das große Inferenzmodell des Unternehmens erreichen kann, während die Parameterzahl etwa ein Fünftel davon beträgt. Im Leistungsvergleich mit vergleichbaren offenen Modellen erreicht sein Inferenzdurchsatz bis zu das Fünffache konkurrierender Modelle. Das Modell kann Webseiten und PDF-Dateien mit Text, Bildern, Diagrammen und Tabellen verarbeiten und unterstützt kundenspezifisches Training auf Basis unternehmensinterner Daten.
Das Training von Super VL verwendete etwa 26 Billionen Token für Vor- und kontinuierliches Training sowie etwa 3,8 Millionen Nachtrainingsbeispiele und optimierte die Modellleistung durch mehrere Umgebungen für bestärkendes Lernen. NVIDIA hat gleichzeitig die Modellgewichte, Trainingsmethoden und Datensätze für Tool-Aufrufe, Finanzgeschäfte, Langkontextverarbeitung, Sicherheit und visuell-sprachliches Verständnis offengelegt. Entwickler können über NVIDIA NeMo und NeMo Gym Feinabstimmung und Training mit bestärkendem Lernen durchführen und das Modell mithilfe von NVIDIA NIM Microservices bereitstellen.
Das für den lokalen Betrieb ausgelegte Bolt 74B-A9B verwendet eine Mixture-of-Experts-Architektur mit insgesamt 74 Milliarden Parametern, wobei pro Inferenz etwa 9 Milliarden Parameter aktiviert werden. Durch native 2-Bit-Quantisierungstechnologie wird der für den Betrieb erforderliche Modellspeicher auf 24 GB begrenzt, sodass es auf GeForce RTX-Computern, DGX Spark, DGX Station und RTX PRO-Workstations eingesetzt werden kann. NVIDIA bietet bereits Laufzeitunterstützung für llama.cpp, Ollama, LM Studio, Unsloth und vLLM, sodass Anwender lokal Agentenaufgaben wie Codeerstellung, Software-Debugging und Informationsabruf ausführen können.
Das andere Modell, Bolt E4B, richtet sich an Konfigurationen mit 4 GB Arbeitsspeicher und ist mit den Plattformen GeForce RTX, Jetson und RTX Spark kompatibel. Es unterstützt mehrrundige Dialoge, Sprachassistenten, interaktive Charaktere und eingebettete intelligente Endgeräte. NVIDIA positioniert es für Anwendungen der physischen künstlichen Intelligenz und dialogorientierter Agenten und deckt damit Unterhaltungsgeräte, Fahrzeuginteraktionssysteme und andere Endgeräte ab, die lokale Inferenz erfordern.
NVIDIA hat außerdem Fortschritte bei der unternehmensspezifischen Anpassung und Softwareintegration von Super VL bekannt gegeben. Scale AI hat das Nachtraining des Modells für den Lieferantenkreditfinanzierungs-Agenten von Skydance und den M&A-Due-Diligence-Agenten von EY abgeschlossen; AfterQuery entwickelte für Hebbia ein Modell zur Analyse von Kreditverträgen; Mercor nutzte APEX-SWE-Codebewertungsdaten für das Modelltraining. Auch Atlassian, CrowdStrike, Dassault Systèmes, Perplexity, Salesforce und Synopsys haben jeweils Integrationen in den Bereichen Suche, Sicherheitsanalyse, Engineering-Design, Verwaltungsprozesse und Halbleiterdesign-Verifikation begonnen.
Bei der Inferenzbereitstellung unterstützt Super VL die NVIDIA Dynamo-Laufzeitumgebung. Die von NVIDIA veröffentlichten Leistungsdaten zeigen, dass diese Kombination in der entsprechenden Testkonfiguration bis zu die achtfache Nutzerzahl unterstützen und gleichzeitig die Latenz um 85 % senken kann. Das Modell ist jetzt über Hugging Face, OpenRouter, ModelScope und NVIDIA NIM verfügbar. Unternehmen können es auf eigenen Servern, in Rechenzentren oder in Cloud-Umgebungen bereitstellen und das Modell entsprechend ihren internen Geschäftsprozessen weiter trainieren und anpassen.
relevante Produkte

Komplettlösungen aus einer Hand für die gesamte Wertschöpfungskette der Logistiksystemintegration
Zhongding Intelligent (Wuxi) Technology Co., Ltd.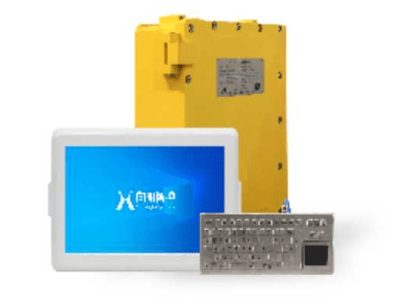
KJD127(A) Bergbau-explosionsgeschützter und eigensicherer Computer
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.
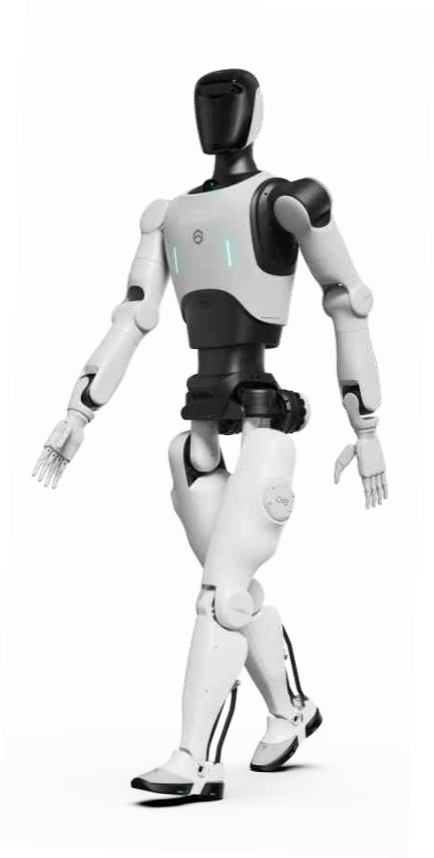
D12 humanoider Roboter
Automation Research Institute Co., Ltd. of China South Industries Group Corporation
Baolande Application Server Software V9.5
Beijing Baolande Software Corporation
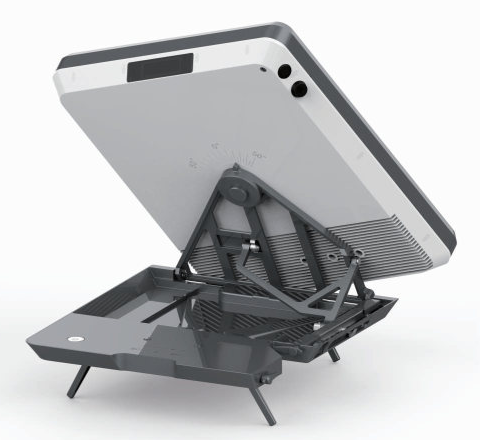
Tragbares Satellitenterminal mit Flachbildschirm – manuelles tragbares Terminal mit 0,35-Meter-Öffnung
China Starwin Science & Technology co., Ltd.
TWP16 P-Band-Troposphären-Windprofiler-Radar
China Huayun Meteorological Technology Group Co., Ltd.