Meituan aus China veröffentlicht multimodales Großmodell LongCat-2.5
de.wedoany.com-Bericht: Am 2. November hat Meituan aus China offiziell die neue Modellgeneration LongCat-2.5 vorgestellt. Es handelt sich um ein natives multimodales Modell für langfristige Agentenaufgaben mit einer Gesamtparameterzahl von 1,6 Billionen, wobei pro Token etwa 48 Milliarden Parameter aktiviert werden. Im Vergleich zum Vorgänger LongCat-2.0 wurden die native visuelle Verständnisfähigkeit und die Agenten-Programmierfähigkeiten des neuen Modells weiter verbessert, mit Schwerpunkt auf der Entwicklung komplexer Codebasen, dem Aufbau vollständiger Softwareprojekte sowie mehrstufigen Aufgaben, die eine kontinuierliche Ausführung erfordern.
LongCat-2.5 verbessert durch Anpassung der Trainingsdaten und des Reinforcement-Learning-Prozesses die Fähigkeit des Modells, langfristige Aufgaben zu bewältigen. Meituan hat in das Langsequenz-Training mehr Daten zu langfristigen Aufgabenverläufen aufgenommen und setzt umfangreiches langfristiges Reinforcement Learning ein, damit das Modell bei komplexen Softwareentwicklungsprozessen über eine stärkere kontinuierliche Ausführungsfähigkeit verfügt. Das Entwicklungsteam hat zudem Fehlverläufe, die bei der Ausführung realer Agentenaufgaben entstehen, in reproduzierbare und verifizierbare Trainingsaufgaben umgewandelt und dann gezielt Trainingsdaten zur Behebung der aufgedeckten Fähigkeitslücken des Modells ergänzt, um die Ausführungsergebnisse bei komplexen Aufgaben zu verbessern.
Bei der multimodalen Verarbeitung setzt LongCat-2.5 auf einen nativen visuellen Verständnisansatz, der visuelle Signale als mehrstufige diskrete Token darstellt, sodass das Modell visuelle und textuelle Eingaben innerhalb eines einheitlichen Token-Rahmens verarbeiten kann. Dieses Design ermöglicht es dem Modell nicht nur, Bildinformationen zu verstehen, sondern die visuelle Verständnisfähigkeit auch für Programmieraufgaben einzusetzen und Anwendungsszenarien wie Visual Coding, kreatives Design und 3D-Inhaltsgenerierung zu unterstützen.
In der Mitteltrainingsphase setzt Meituan auf Langkontext-Sequenztraining mit bis zu 1 Million Token und einem kumulierten Trainingsvolumen von mehreren Billionen Token und optimiert dabei die Speichernutzung, die Kommunikation zwischen den Karten und die Rechenressourcenplanung für die inländische Rechenumgebung. In den von Meituan veröffentlichten Tests zum überwachten Feintuning mit langem Kontext erzielte der optimierte Single-Card-Trainingsdurchsatz eine Steigerung von 86 % gegenüber der Distributed Data Parallel (DDP)-Basislinie.
In der Inferenzphase wird ein W4A4-Quantisierungsschema eingesetzt, das die Expertengewichte und Aktivierungen des Modells gleichzeitig auf 4 Bit quantisiert, um den Rechen- und Datenübertragungsaufwand zu reduzieren. Meituans Online-Stresstests zeigen, dass das neue Schema im Vergleich zur W8A8-INT8-Basislinie, bei der sowohl Gewichte als auch Aktivierungen mit 8 Bit quantisiert werden, den Durchsatz bei der Eingabeverarbeitung und der Token-für-Token-Generierung um jeweils etwa 40 % steigert, die Wartezeit bis zur ersten Ausgabe um etwa 16 % verkürzt und die Generierungszeit pro nachfolgendem Token um etwa 20 % reduziert. Diese Daten stammen aus einer unternehmenseigenen spezifischen Testumgebung und bedeuten nicht, dass in allen Bereitstellungsszenarien Leistungssteigerungen in gleichem Umfang erzielt werden können.
Nutzer können das Modell online über die offizielle LongCat-Website testen, Entwickler können es über die API-Plattform aufrufen. Den vom Meituan-Technikteam veröffentlichten Informationen zufolge sind Versionen für GitHub und Hugging Face für eine spätere Veröffentlichung geplant. Zu den Anwendungsbereichen des neuen Modells gehören komplexe Softwareentwicklung, visuelles Programmieren und kreatives Design sowie weitere Aufgaben, die eine mehrstufige Verarbeitung erfordern.
relevante Produkte

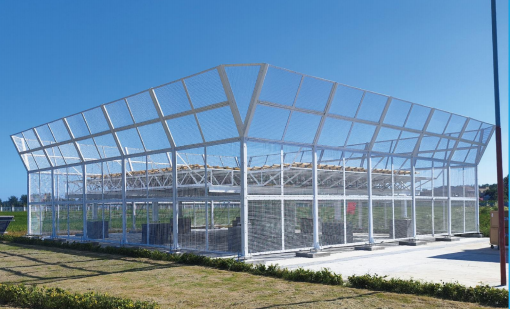
TWP16 P-Band-Troposphären-Windprofiler-Radar
China Huayun Meteorological Technology Group Co., Ltd.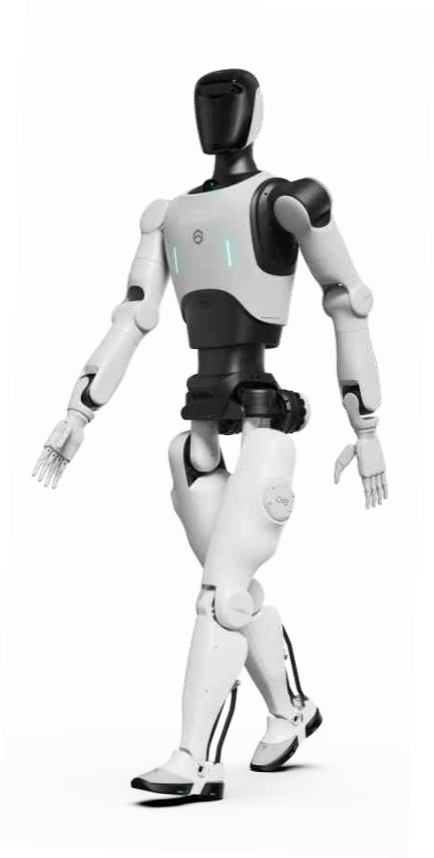
D12 humanoider Roboter
Automation Research Institute Co., Ltd. of China South Industries Group Corporation
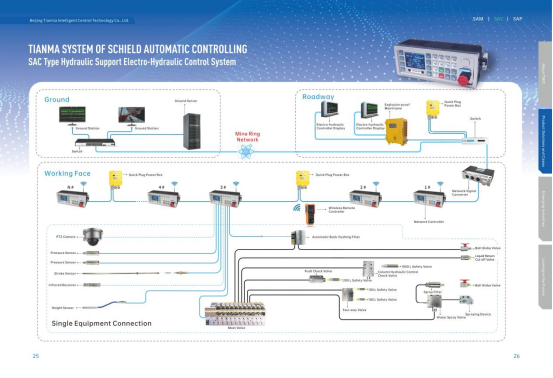
Elektrohydraulisches Steuerungssystem für SAC-Hydraulikausbaugestelle
Beijing Tianma Intelligent Control Technology Co., Ltd.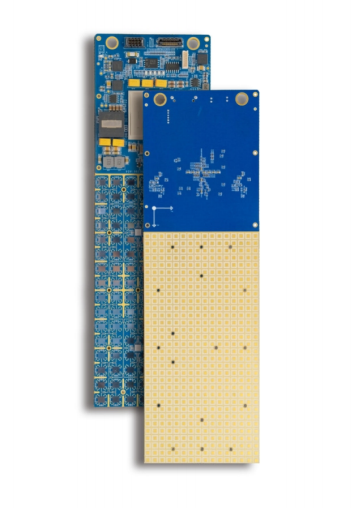
Kollaboratives Energiemanagement- und Steuerungssystem für Cloud, Edge und Endgeräte
Beijing Agent Devote Power Technology Development Co., Ltd.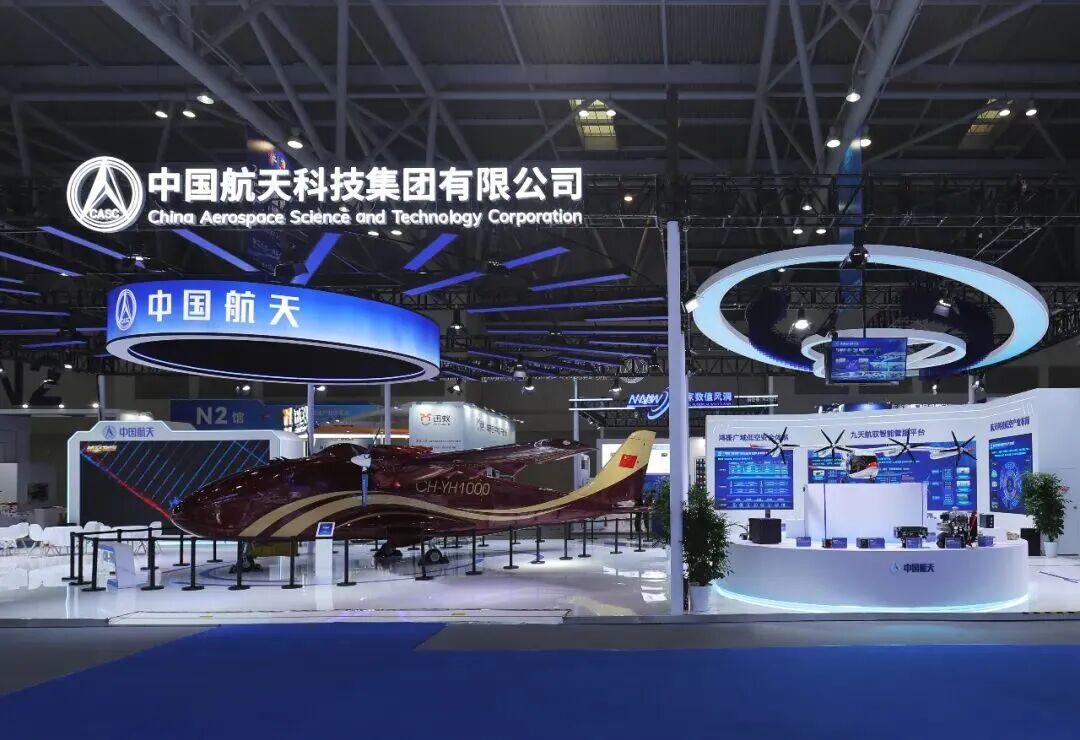
JiuTian HangYu – Intelligente Management- und Serviceplattform „JiuTian" OneSky Pilot-Intelligent Management And Service Platform
China Times Prospect Science & Technology Co., Ltd.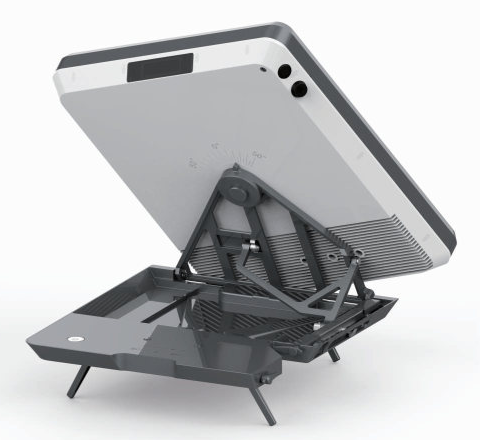
Tragbares Satellitenterminal mit Flachbildschirm – manuelles tragbares Terminal mit 0,35-Meter-Öffnung
China Starwin Science & Technology co., Ltd.