Supermicro bringt gemeinsam mit IBM und NVIDIA eine KI-Inferenz-Caching-Lösung auf den Markt
de.wedoany.com-Bericht: Am 5. November stellte der US-Serverhersteller Supermicro gemeinsam mit IBM und NVIDIA eine KV-Cache-Speicherlösung für KI-Inferenz vor, die Supermicros Petascale-All-Flash-Server, die Speichersoftware IBM Storage Scale, das NVIDIA-Dynamo-Inferenzframework und die Spectrum-X-Ethernet-Technologie integriert. Die drei Parteien führten Tests mit einem großen Sprachmodell mit 120 Milliarden Parametern durch. Bei einer langen Kontexteingabe von 130.000 Token erreichte das System mit persistentem KV-Cache eine Generierungsgeschwindigkeit für das erste Token von bis zu dem 56-Fachen der Lösung ohne Cache.
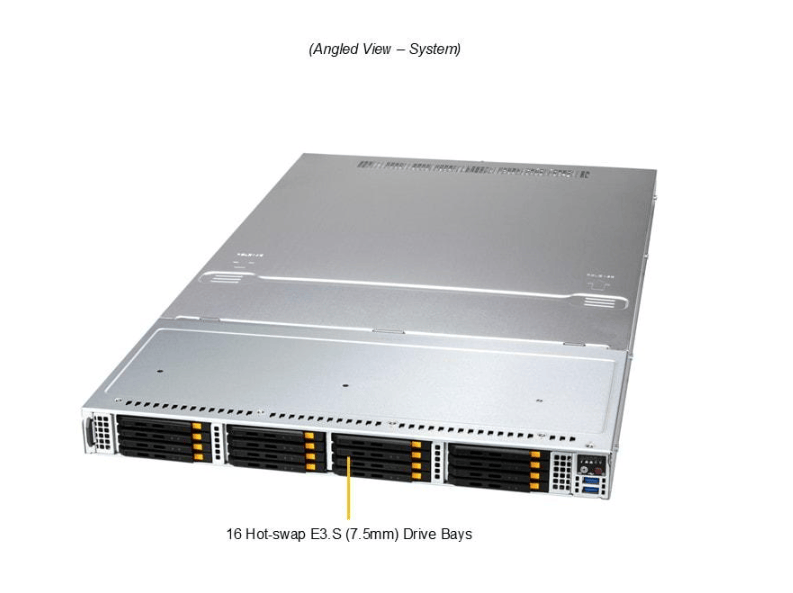
Die Lösung verwendet Petascale-All-Flash-Server mit Prozessoren der AMD-EPYC-9005-Serie und errichtet über IBM Storage Scale in der Edition mit Erasure Coding eine gemeinsame Speicherschicht. NVIDIA Dynamo ist für verteilte Inferenzaufgaben und die KV-Cache-Verwaltung zuständig, während Spectrum-X-Ethernet-Switches die GPU-Rechenknoten mit dem Speichercluster verbinden. Das System kann berechnete KV-Zustände außerhalb des GPU-Speichers in einem gemeinsamen Speicherbereich ablegen und bei nachfolgenden Inferenzanfragen erneut abrufen.
In einem von Supermicro und NVIDIA gemeinsam durchgeführten Langkontexttest stieg bei einer Zunahme der Eingabelänge von 30.000 Token auf 130.000 Token die Generierungszeit für das erste Token bei dem System mit persistentem KV-Cache lediglich um 0,377 Sekunden, während sie bei dem Kontrollsystem ohne KV-Cache um 29,55 Sekunden zunahm. Die Testergebnisse gelten für das angegebene Modell, die Hardwarekonfiguration und die Bedingungen der Cache-Wiederverwendung.
Die drei Parteien führten zudem eine Validierung auf Clusterebene in Umgebungen mit hoher Parallelität und konkurrierender Netzwerkressourcennutzung durch. Die von IBM veröffentlichten technischen Testergebnisse zeigen, dass mit der gemeinsamen KV-Cache-Architektur der Durchsatz bei paralleler Inferenz von 0,19 Anfragen pro Sekunde auf 4,26 Anfragen pro Sekunde gesteigert wurde, was etwa dem 22-Fachen des Referenzsystems entspricht, und dass sich die Gesamtverarbeitungszeit für 200 Anfragen um 95 % verringerte.
In einem Netzwerkbelastungstest erzeugten vier gleichzeitige Clients einen konkurrierenden Netzwerkverkehr von insgesamt 200 GB pro Sekunde. Das System mit IBM Storage Scale hielt weiterhin 3,6 Inferenzanfragen pro Sekunde aufrecht, benötigte für 200 Anfragen 55,56 Sekunden und erzielte damit einen Durchsatz von etwa dem 18-Fachen der Referenzlösung, bei der die GPU den Cache neu berechnet.
Supermicro bietet für die Lösung zudem rackgestützte Werksintegration und Vor-Ort-Bereitstellungsdienste an, die die gemeinsame Konfiguration von Servern, Speichersoftware, Netzwerk-Switching-Geräten und Inferenzframework umfassen. Das Unternehmen gibt an, dass sich durch vorkonfigurierte und validierte Systemkonfigurationen der Bereitstellungszyklus der betreffenden Infrastruktur von mehreren Wochen auf mehrere Tage verkürzen lässt.
relevante Produkte

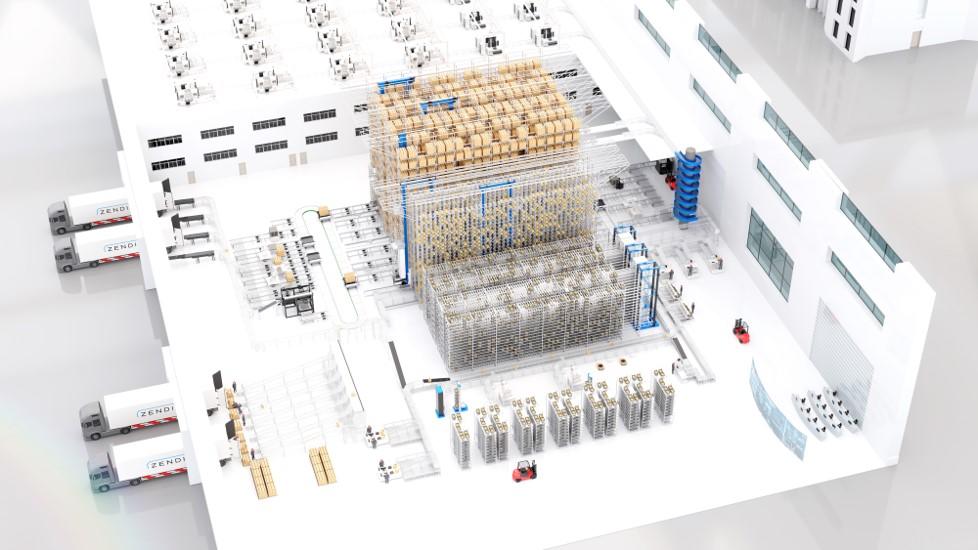
Komplettlösungen aus einer Hand für die gesamte Wertschöpfungskette der Logistiksystemintegration
Zhongding Intelligent (Wuxi) Technology Co., Ltd.
KJD127(A) Bergbau-explosionsgeschützter und eigensicherer Computer
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.
SIS-Sicherheitsinstrumentierungslösung
Beijing Consen Automation Technology Co., Ltd.
Intelligentes Überwachungssystem für Förderbänder
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
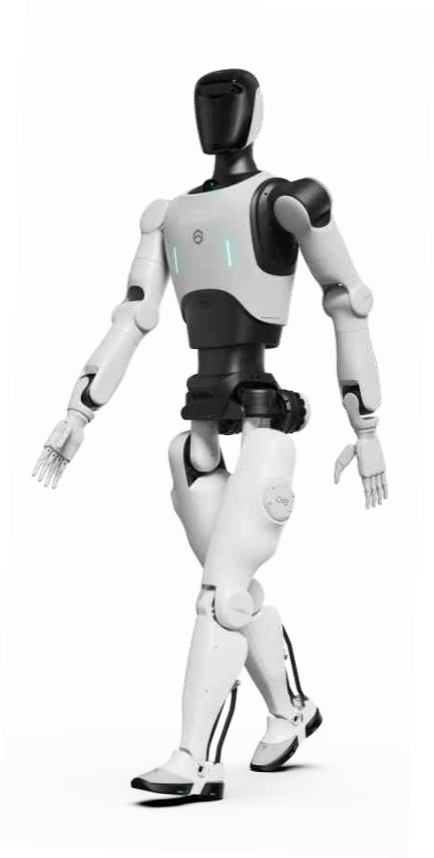
D12 humanoider Roboter
Automation Research Institute Co., Ltd. of China South Industries Group Corporation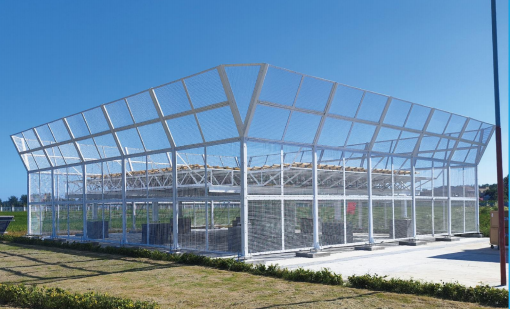
TWP16 P-Band-Troposphären-Windprofiler-Radar
China Huayun Meteorological Technology Group Co., Ltd.
Kollaboratives Energiemanagement- und Steuerungssystem für Cloud, Edge und Endgeräte
Beijing Agent Devote Power Technology Development Co., Ltd.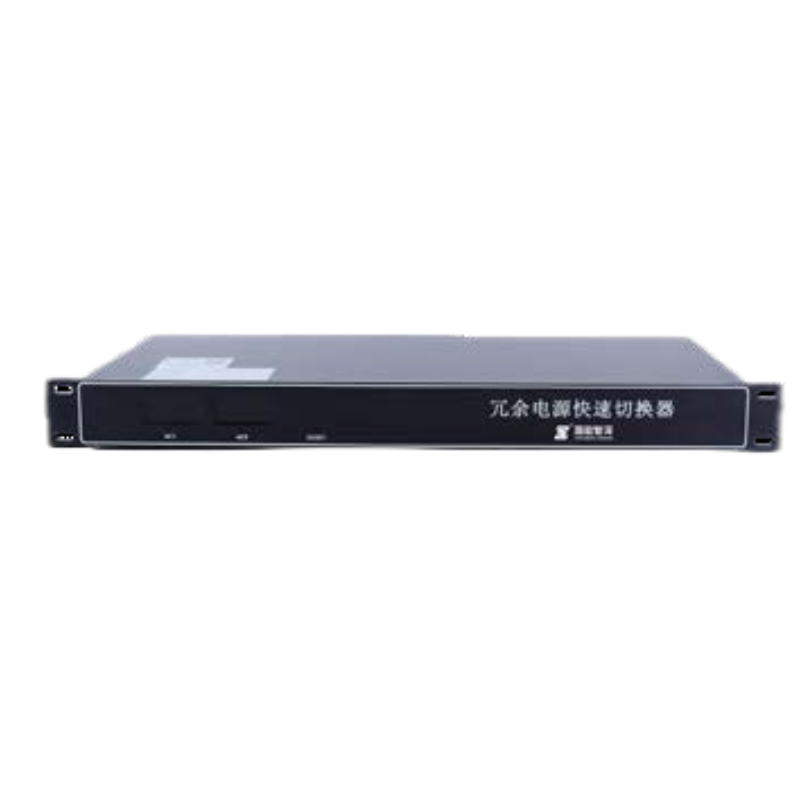
QPS-20A schnelles Umschaltgerät für redundante Stromversorgung
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.