US-Parasail kombiniert NVIDIA-GPUs mit d-Matrix Corsair für schnellere Token-Generierung
de.wedoany.com-Bericht: Das US-amerikanische Neocloud-Unternehmen Parasail setzt NVIDIA Hopper- und Blackwell-GPUs in Kombination mit dem d-Matrix Corsair-Inferenzbeschleuniger ein, um eine heterogene KI-Inferenz-Infrastruktur aufzubauen. Die Lösung ist auf große Sprachmodelle für Inferenzdienste ausgerichtet und kann die Token-Generierungsrate um bis zu das Zehnfache steigern sowie die Kosteneffizienz der Inferenzdienste verbessern.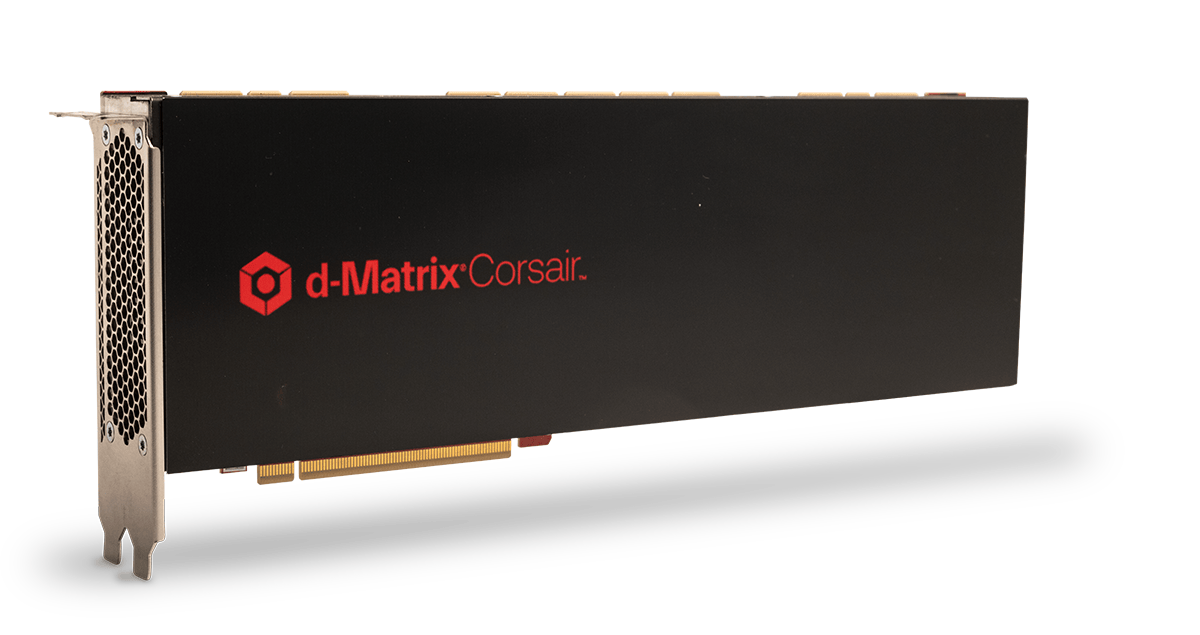
Der Schlüssel dieser Infrastruktur liegt darin, die Inferenzaufgabe in zwei verschiedene Phasen zu unterteilen. Die Prefill-Phase im vorderen Teil der großen Sprachmodell-Inferenz muss Eingabekontext, Prompts, Gesprächsverlauf und lange Textinhalte verarbeiten, was rechenintensiv ist und sich besser für NVIDIA Hopper- und Blackwell-GPUs eignet; die Decode-Phase im hinteren Teil der Inferenz muss Token einzeln generieren und ist empfindlicher gegenüber Latenz, Speicherzugriff und kontinuierlichem Durchsatz, was sich besser für spezialisierte Inferenz-ASICs wie den d-Matrix Corsair eignet. Parasail nutzt eine automatische Kernel-Optimierungstechnologie, um die Arbeitslast dynamisch auf verschiedene Hardware zu verteilen, sodass GPUs und spezialisierte ASICs jeweils Aufgaben ausführen, die besser zu ihrer Architektur passen, anstatt die gesamte Inferenzkette auf einen einzigen Chip zu laden.
Der d-Matrix Corsair verwendet eine digitale In-Memory-Computing-Architektur, die Recheneinheiten und Speicherressourcen enger in derselben Chipstruktur zusammenbringt. In herkömmlichen Inferenzsystemen müssen Daten häufig zwischen Prozessor und externem Speicher hin- und herbewegt werden, was Zeit-, Energie- und Kostenaufwand verursacht; der Corsair reduziert diese Datenbewegungen durch die D-IMC-Architektur. Der Chip basiert auf dem TSMC-N6-Prozess und verwendet ein organisches Substrat sowie LPDDR5-Speicher, ausgelegt für skalierbare Inferenzbereitstellung in Rechenzentren.
Die Bereitstellung von Parasail ist ein Beispiel für eine produktionsreife heterogene entkoppelte Inferenz. Die Plattform des Unternehmens bündelt leistungsstarke GPU-Ressourcen aus über 40 Rechenzentren in mehr als 15 Ländern und bietet Entwicklern Modell-Endpunkte und Inferenzdienste; durch die Integration des Corsair in die bestehende NVIDIA-Infrastruktur kann die Inferenzkette eine Arbeitsteilung zwischen GPU-Prefill und ASIC-Dekodierung bilden, was die Auslastung der vorhandenen Hopper- und Blackwell-Cluster verbessert.
Heterogene Inferenz bedeutet nicht einfach das Hinzufügen eines weiteren Chips, sondern verändert den Ausführungspfad des Inferenzdienstes. Die Prefill-Phase konzentriert sich auf groß angelegte Matrixberechnungen und Kontextverarbeitung, wobei die parallele Rechenleistung der GPUs für solche Hochdurchsatzaufgaben geeignet ist; die Decode-Phase liest kontinuierlich Modellzustände, Caches und neu generierte Token und ist empfindlicher gegenüber Speicherzugriff, Antwortlatenz und Energieeffizienz. Indem der Corsair Rechnen und Speichern näher zusammenbringt, kann der Druck der Datenbewegung während der Dekodierung verringert werden, wodurch die Token-Generierung besser für eine niedrige Latenzausgabe geeignet ist.
Das Produktportfolio von d-Matrix umfasst auch den Corsair-Inferenzbeschleuniger, den JetStream-Netzwerkbeschleuniger, die Aviator-Software und die SquadRack-Rack-Level-Lösung, mit dem Ziel, eine latenzarme und energieeffiziente Infrastruktur für KI-Inferenz in Rechenzentrumsgröße bereitzustellen. Nachdem Parasail den Corsair in den NVIDIA-GPU-Ressourcenpool integriert hat, entsteht kein GPU-Ersatz, sondern ein hybrides Bereitstellungsmodell, bei dem GPUs und spezialisierte Inferenzbeschleuniger gemeinsam verschiedene Inferenzphasen übernehmen.
Weitere Leistungsdetails werden durch Testergebnisse und Fallstudien nach der ersten Bereitstellung veröffentlicht. Die aktuelle Architektur ist bereits klar: Hopper- und Blackwell-GPUs übernehmen die rechenintensive Prefill-Phase, der Corsair-ASIC die latenzempfindliche Decode-Phase, und Parasail verteilt durch dynamisches Routing und Kernel-Optimierung die Arbeitslasten verschiedener Modelle auf die geeignete Hardware, um letztendlich Cloud-basierte Token-Dienste für Entwickler und Unternehmenskunden bereitzustellen.
relevante Produkte

Tragbares Satellitenterminal mit Flachbildschirm – manuelles tragbares Terminal mit 0,35-Meter-Öffnung
China Starwin Science & Technology co., Ltd.
Kollaboratives Energiemanagement- und Steuerungssystem für Cloud, Edge und Endgeräte
Beijing Agent Devote Power Technology Development Co., Ltd.
JiuTian HangYu – Intelligente Management- und Serviceplattform „JiuTian" OneSky Pilot-Intelligent Management And Service Platform
China Times Prospect Science & Technology Co., Ltd.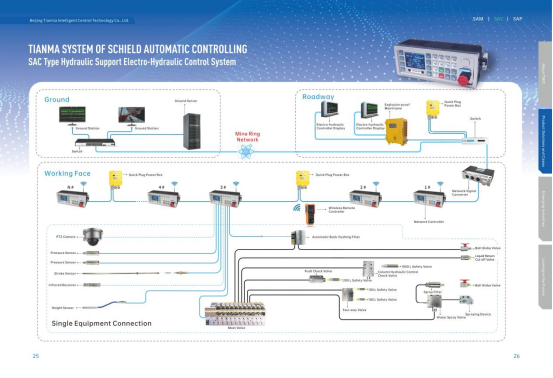
Elektrohydraulisches Steuerungssystem für SAC-Hydraulikausbaugestelle
Beijing Tianma Intelligent Control Technology Co., Ltd.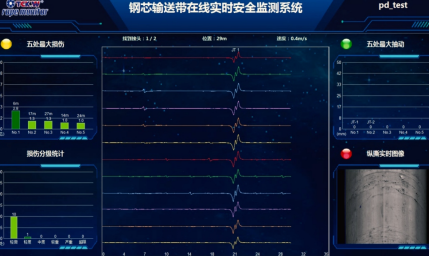
Intelligentes Überwachungssystem für Förderbänder
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Baolande Application Server Software V9.5
Beijing Baolande Software Corporation
KJD127(A) Bergbau-explosionsgeschützter und eigensicherer Computer
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.